728x90
반응형

전체 글 371

[Python] matplotlib 차트(Pie Charts, 파이 차트)

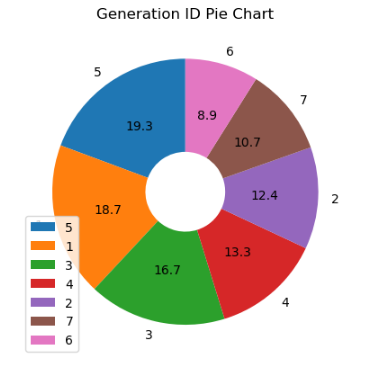
데이터를 퍼센테이지로 비교해서 보고 싶을때 사용 generation_id 별로 데이터의 갯수를 퍼센테이지로 비교할 수 있도록 파이차트로 나타내보자!df2 = df['generation_id'].value_counts()plt.pie(df2, labels=df2.index, autopct='%.1f', startangle=90, wedgeprops={'width':0.7})plt.legend()plt.title('Generation ID Pie Chart')# %.2f : 소수점 2자리까지 퍼센트로 나타내라# wedgeprops={'width':0.7} : 가운데 구멍 뚫기(도넛모양)plt.show() type_1 의 데이터를 보니까 총 18개인데 데이터의 갯수가 가장 많은 순으로 상위 6개만 카운트 플..
Python 2026.10.25

[Python] seaborn 차트(Bar Chart, 바 차트) 예제

type_1 으로 바 차트 표시하기sb.countplot(data= df, x='type_1', color=base_color)plt.show() 내림차순으로 정렬하여 바차트 표시하기 base_order3 = df['type_1'].value_counts().index # 인덱스만 추출하기base_order3sb.countplot(data= df, x='type_1', order=base_order3)plt.show() 오름차순으로 바 차트 표시하기base_order4 = list(reversed(base_order3))base_order4sb.countplot(data= df, x='type_1', color=base_color, order=base_order4)plt.show() x축 label을 조..

Python 2026.10.25

[Python] seaborn 차트 만들기(Bar Chart, 바 차트)

Bar Chart(막대 차트)import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as sb csv 파일 데이터를 가져온다 generation_id 는 데이터가 중복되어 있는 것 같다. = 카테고리컬 데이터df['generation_id'].nunique()df['generation_id'].unique() 각 제너레이션 아이디 별로 캐릭터가 몇개씩 있는가?df['generation_id'].value_counts() # value_counts : 해당 컬럼의 값의 갯수 특정 컬럼이 카테고리컬 데이터 일때 각 데이터가 몇개씩 있는지 차트로 나타내고 싶으면 seaborn의 countplot 함수를 사용하면 됨sb..

Python 2026.10.25

[Python] Matplotlib 차트 만들기(Line Chart, 라인 차트)

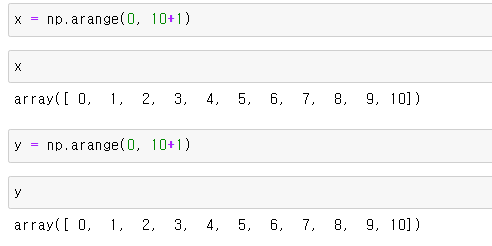
가장 기본적인 라인차트인 plotimport matplotlib.pyplot as pltimport numpy as npx = np.arange(0, 10+1)xy = np.arange(0, 10+1)y # 선으로 연결된 차트를 그리는 방법(라인 차트)plt.plot(x,y)plt.savefig('test1.jpg') # 차트를 파일로 저장하는 방법(주피터 노트북 디렉토리 폴더에 저장됨)plt.show() # 메모리 상태 지우고 차트만 표시 x=np.arange(0,10+1,0.1)y = np.sin(x)plt.plot(x,y)plt.show()

Python 2026.10.24

[pandas] pandas SORTING AND ORDERING

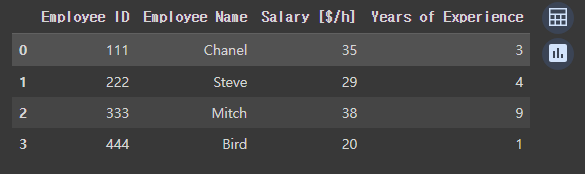
경력 오름차순으로 정렬하세요df['Years of Experience'].sort_values() # 해당 컬럼만 정렬df.sort_values('Years of Experience') 경력 내림차순으로 정렬하세요df.sort_values('Years of Experience',ascending=False) length 컬럼을 내림차순으로 정렬하세요df.sort_values('length', ascending=False)정렬 조건이 두개 이상일 경우 정렬 방법 length를 내림차순으로 정렬하되, 숫자가 같으면 이름을 오름차순으로 정렬하세요df.sort_values(['length','Employee Name'], ascending=[False, True])

Python/Pandas 2026.10.24

[pandas] pandas APPLYING FUNCTIONS

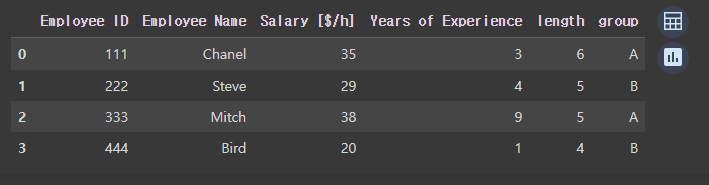
직원 이름이 몇글자인지 글자수를 세어서 새로운 컬럼 length를 만드세요df['Employee Name'].str.len() df['length'] = df['Employee Name'].str.len()df시급이 30 이상이면, 'A'그룹이라 하고, 시급이 30보다 작으면 'B'그룹이라고 함 (조건문) 새로운 컬럼 group을 만들어서 저장하세요 df['Salary [$/h]']함수 만드는 순서 1. 함수의 호출부분을 먼저 작성한다. 2. 호출부분을 참고하여 함수를 정의한다.def grouping(Salary): # 함수만들기 : def if Salary >= 30: return 'A' else: return 'B' df['group'] = df['Salary [$/h]'].ap..

Python/Pandas 2026.10.24

[pandas] pandas 실습예제 3

import pandas as pdreviews = pd.read_csv('/content/drive/MyDrive/Notebooks/data/wine-data.csv',index_col=0)reviews 리뷰 데이터프레임에서 points 컬럼의 median 값은?reviews['points'].median() 나라를 중복되지 않도록 가져와서 countries 변수에 저장하고, 화면에 출력하시오.countries = reviews['country'].unique()countries 각 국가별로는 몇개의 리뷰가 있는지, 각국가별 리뷰수를 구하시오.reviews.groupby('country').size()reviews['country'].value_counts() 리뷰 데이터프레임의 price 컬럼 값에서..

Python/Pandas 2026.10.24

[pandas] pandas 실습예제 2

import pandas as pdreviews = pd.read_csv('/content/drive/MyDrive/Notebooks/data/wine-data.csv',index_col=0)reviews 인덱스를 title 컬럼으로 셋팅한다.reviews.set_index('title', inplace=True) # inplace=True inplace:해당 장소에의 의미, 메모리에서 작업(반영)reviews 먼저 데이터가 비어있느것이 있는지 확인한다.reviews.isna() reviews.isna().sum()그리고나서, 가격이 없는 데이터는 빼고, 데이터셋을 가져온다.reviews['price'].notna() # notna : true = 가격이 있음 reviews = reviews.loc[re..

Python/Pandas 2026.10.24

[pandas] pandas 실습예제 1

구글 코랩에 구글 드라이브 마운트 후 csv 파일을 불러옵니다.import pandas as pdreviews = pd.read_csv('/content/drive/MyDrive/Notebooks/data/winemag-data.csv',index_col=0) # index_col = 인덱스로 사용할 컬럼 선택(컬럼 번호로 작성)reviews 리뷰의 디스크립션 컬럼을 desc 로 저장한다.desc = reviews['description'] first_description 이라는 변수에는, 디스크립션 컬럼의 첫번째 데이터를 저장한다.first_description = reviews['description'][0]reviews.loc[0,'description']reviews.iloc[0, 1] first..

Python/Pandas 2026.10.24
728x90
반응형